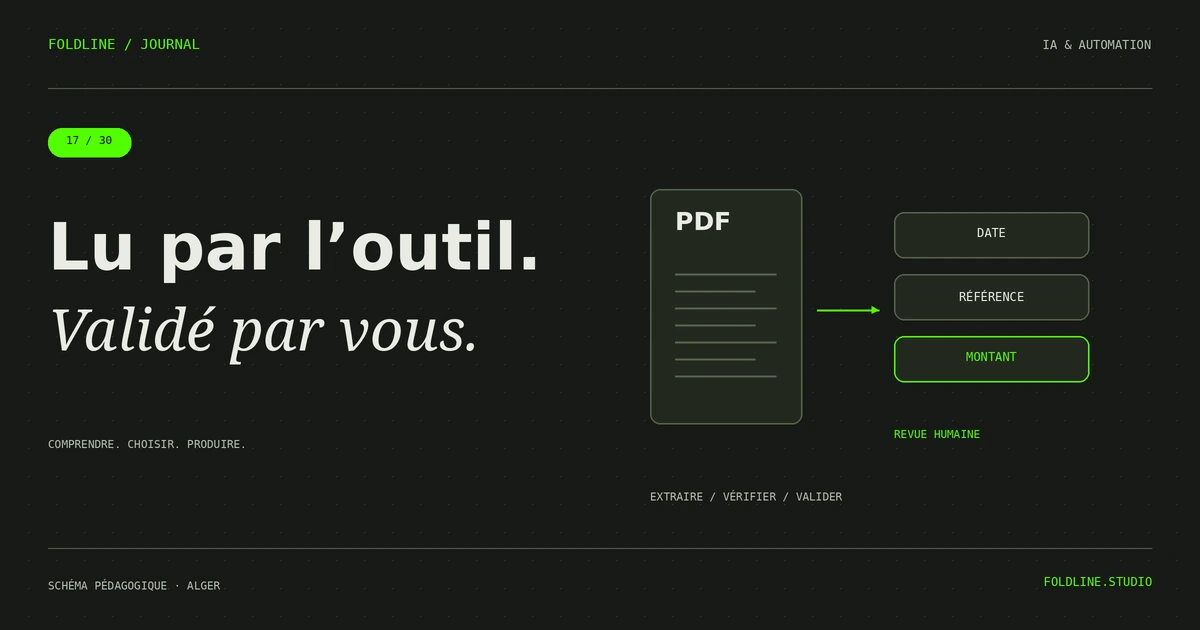
Copier des informations d’un PDF vers un tableau est répétitif, mais une lecture automatique peut aussi se tromper : chiffre mal reconnu, colonne décalée, total pris pour une autre valeur ou fournisseur confondu. Un workflow OCR fiable doit prévoir la vérification et les exceptions dès sa conception.
L’objectif est d’aider la préparation et le classement des données. L’extraction ne constitue pas, à elle seule, une validation comptable, fiscale ou commerciale du document. Les contrôles métier et les personnes habilitées conservent leur rôle.
L’essentiel en 30 secondes
- Séparez réception, extraction, contrôle et validation.
- Conservez le document source avec un lien vers les données extraites.
- Traitez les faibles confiances et incohérences dans une file de revue.
- Ne déclenchez pas un paiement ou une écriture engageante sur la seule lecture OCR.
Définir les champs réellement nécessaires
Listez les informations utiles à votre processus : fournisseur, référence, date, devise, montant et autres champs validés par l’équipe. Précisez le format attendu et la façon de gérer une absence. Ne remplissez pas silencieusement une valeur incertaine avec une supposition.
Certains PDF contiennent déjà du texte ; d’autres sont des images ou des scans. La chaîne doit reconnaître ce qui est disponible et conserver une trace de la méthode utilisée. La qualité des documents d’entrée influence directement le travail de correction.
Une chaîne en cinq étapes
| Étape | Résultat attendu | Contrôle |
|---|---|---|
| Réception | Document identifié | Type, intégrité et origine selon le dispositif |
| Extraction | Champs et valeurs proposés | Conservation de la source et des indications de confiance |
| Normalisation | Dates, nombres et devises structurés | Aucune conversion implicite ambiguë |
| Revue | Dossier accepté ou à corriger | Cohérence et traitement des exceptions |
| Export | Données validées vers le système prévu | Doublons, statut et traçabilité |
La documentation Document AI présente notamment des scores de confiance associés à l’extraction. Un tel score aide à orienter la revue ; il ne garantit pas que la valeur est correcte ni que le document est valide.
Exemple pédagogique : un total mal lu
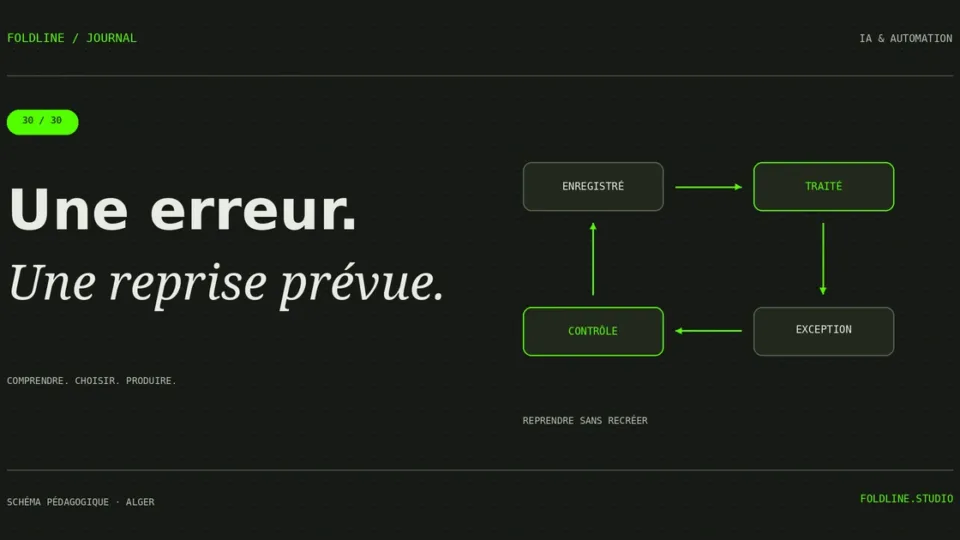
Un document fictif contient un total et un sous-total proches. L’extraction propose la mauvaise valeur avec un résultat apparemment plausible. Le workflow vérifie les relations prévues par l’équipe et signale une incohérence au lieu d’exporter immédiatement.
Un opérateur ouvre le document source, corrige le champ et valide le dossier. La correction est enregistrée avec le statut final. L’exemple montre pourquoi une automatisation utile a besoin de règles métier, pas seulement d’une reconnaissance de caractères performante.
Préparer le jeu de test
Rassemblez un échantillon autorisé et représentatif : formats différents, plusieurs langues si elles existent, documents nets et plus difficiles, cas incomplets et doublons. Masquez ou protégez les informations qui ne sont pas nécessaires au test.
Mesurez l’exactitude des champs importants et le temps de revue. Une moyenne globale peut cacher des erreurs sur un montant ou une référence décisive. Gardez aussi les cas qui doivent être refusés ou transmis à une personne compétente.
Organiser les données et les accès
Définissez qui peut recevoir, consulter, corriger et exporter les documents. Évitez de multiplier les copies dans les emails, tableurs et journaux d’erreurs. La conservation et le choix des prestataires doivent respecter le cadre applicable à votre activité et aux données traitées.
La logique d’une source de vérité rejoint le traitement des leads : l’enregistrement et la traçabilité viennent avant la notification. Le tableau final doit pouvoir renvoyer à la pièce correspondante et à son statut.
Calculer le bénéfice réel
Comparez le temps de saisie initial au temps restant : revue, exceptions, maintenance et correction. Ajoutez les coûts d’extraction et des autres outils. Un workflow qui extrait vite mais exige une relecture longue peut rester pertinent, à condition de mesurer honnêtement ce qu’il apporte.
Le guide des usages de l’IA pour les PME permet de replacer l’extraction dans un processus plus large. Il est préférable de tester un type de document avant de généraliser à toutes les pièces de l’entreprise.
Questions fréquentes
Peut-on supprimer toute validation humaine ?
Ne le présumez pas. Le niveau de contrôle dépend du risque, de la qualité observée et des obligations du processus. Les décisions engageantes doivent conserver les validations appropriées.
Un score de confiance élevé suffit-il ?
Non. Il ne remplace pas les règles de cohérence et la validation du document. Testez les champs critiques séparément.
Peut-on commencer avec un tableur ?
Oui pour un périmètre adapté, si les accès, les versions, les sources et les statuts sont maîtrisés. Le tableur ne doit pas devenir une copie non suivie de données sensibles.
Réduire la recopie sans perdre le contrôle
Étudiez votre flux documentaire avec Foldline à partir de documents autorisés et d’un processus précis. Le pilote pourra mesurer l’extraction et le travail de revue.
Service Foldline · Automatisation & IA
Un projet d'automatisation ? Du brief à la livraison, Foldline accompagne les entreprises à Alger : la page du service détaille ses étapes et ses livrables.